01这项服务报告什么
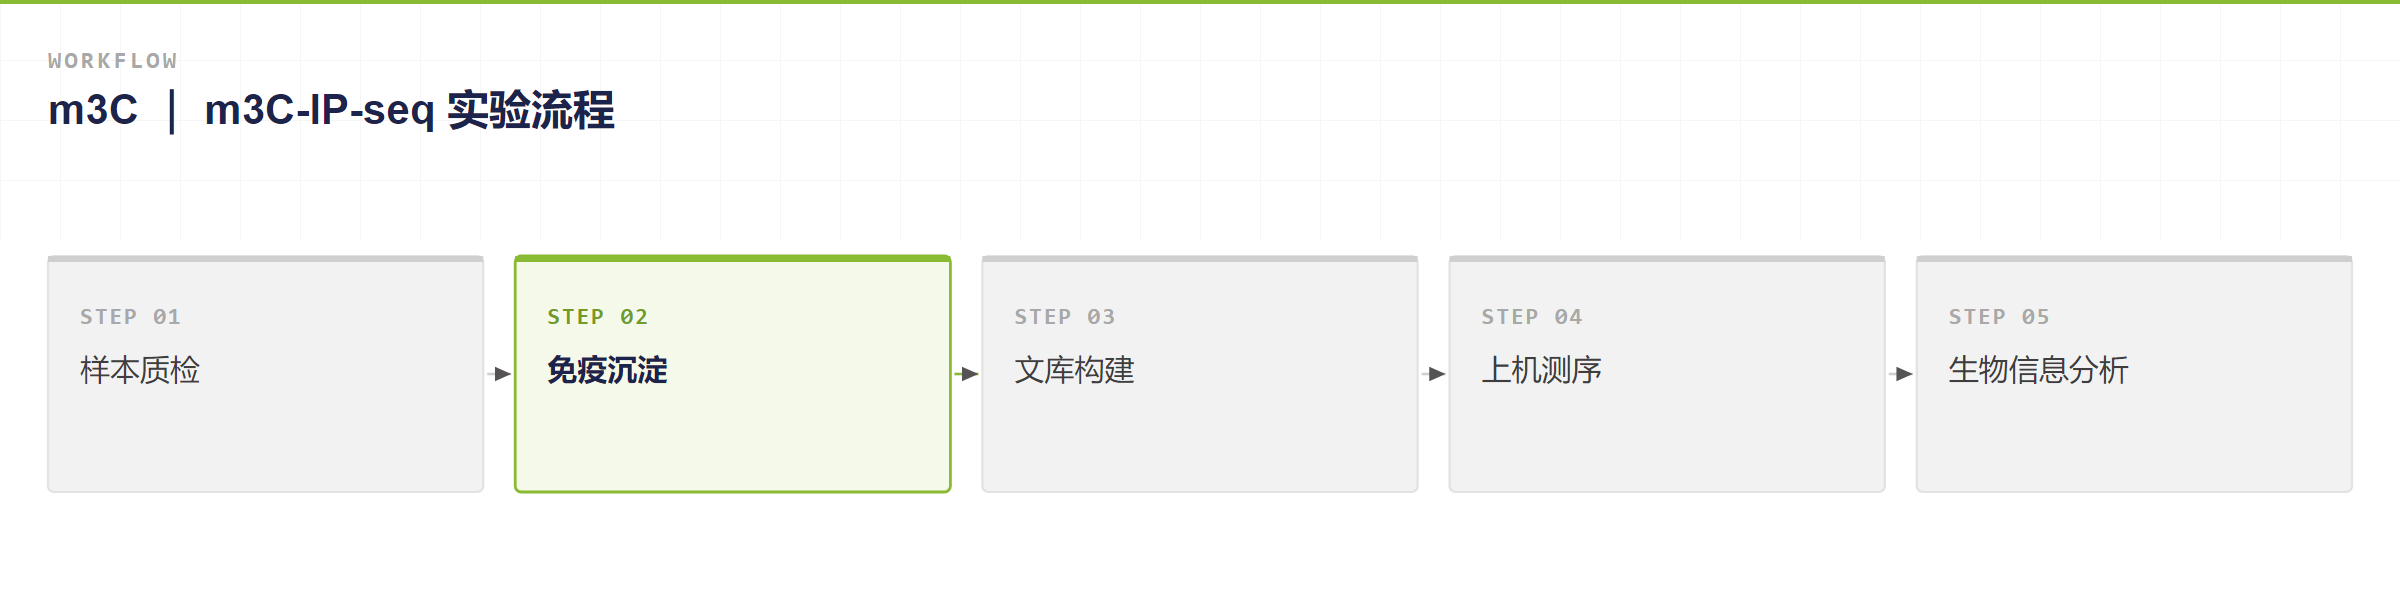
流程自 RNA 样本质检起,依次为免疫沉淀富集、逆转录错配读出与建库、上机测序、生物信息分析。每个位点都会注释到参考转录组,给出基因组坐标、宿主基因与所在功能区域。
服务提供两种转录本范围 —— 只做 mRNA,或把 mRNA 与长链非编码 RNA(lncRNA)放进同一次实验一起分析。
02服务优势
- 富集提升灵敏度:免疫沉淀特异富集含 m3C 的片段,弱修饰位点也能被检出。
- 错配读出定位:富集之后做逆转录错配读出(misincorporation),逆转录在修饰位点处留下特征信号,把修饰核苷酸落到单个碱基上。
- 低丰度友好:先富集再测序以提升信噪比,适合 m3C 丰度偏低的样本。
- 与化学路线互补:可与肼-苯胺切割这类无抗体路线互为正交验证。
- 注释完备:输出逐位点标注基因组坐标、宿主基因与所在功能区域。
可选转录本范围
mRNA|mRNA 与 lncRNA03背景与检测原理
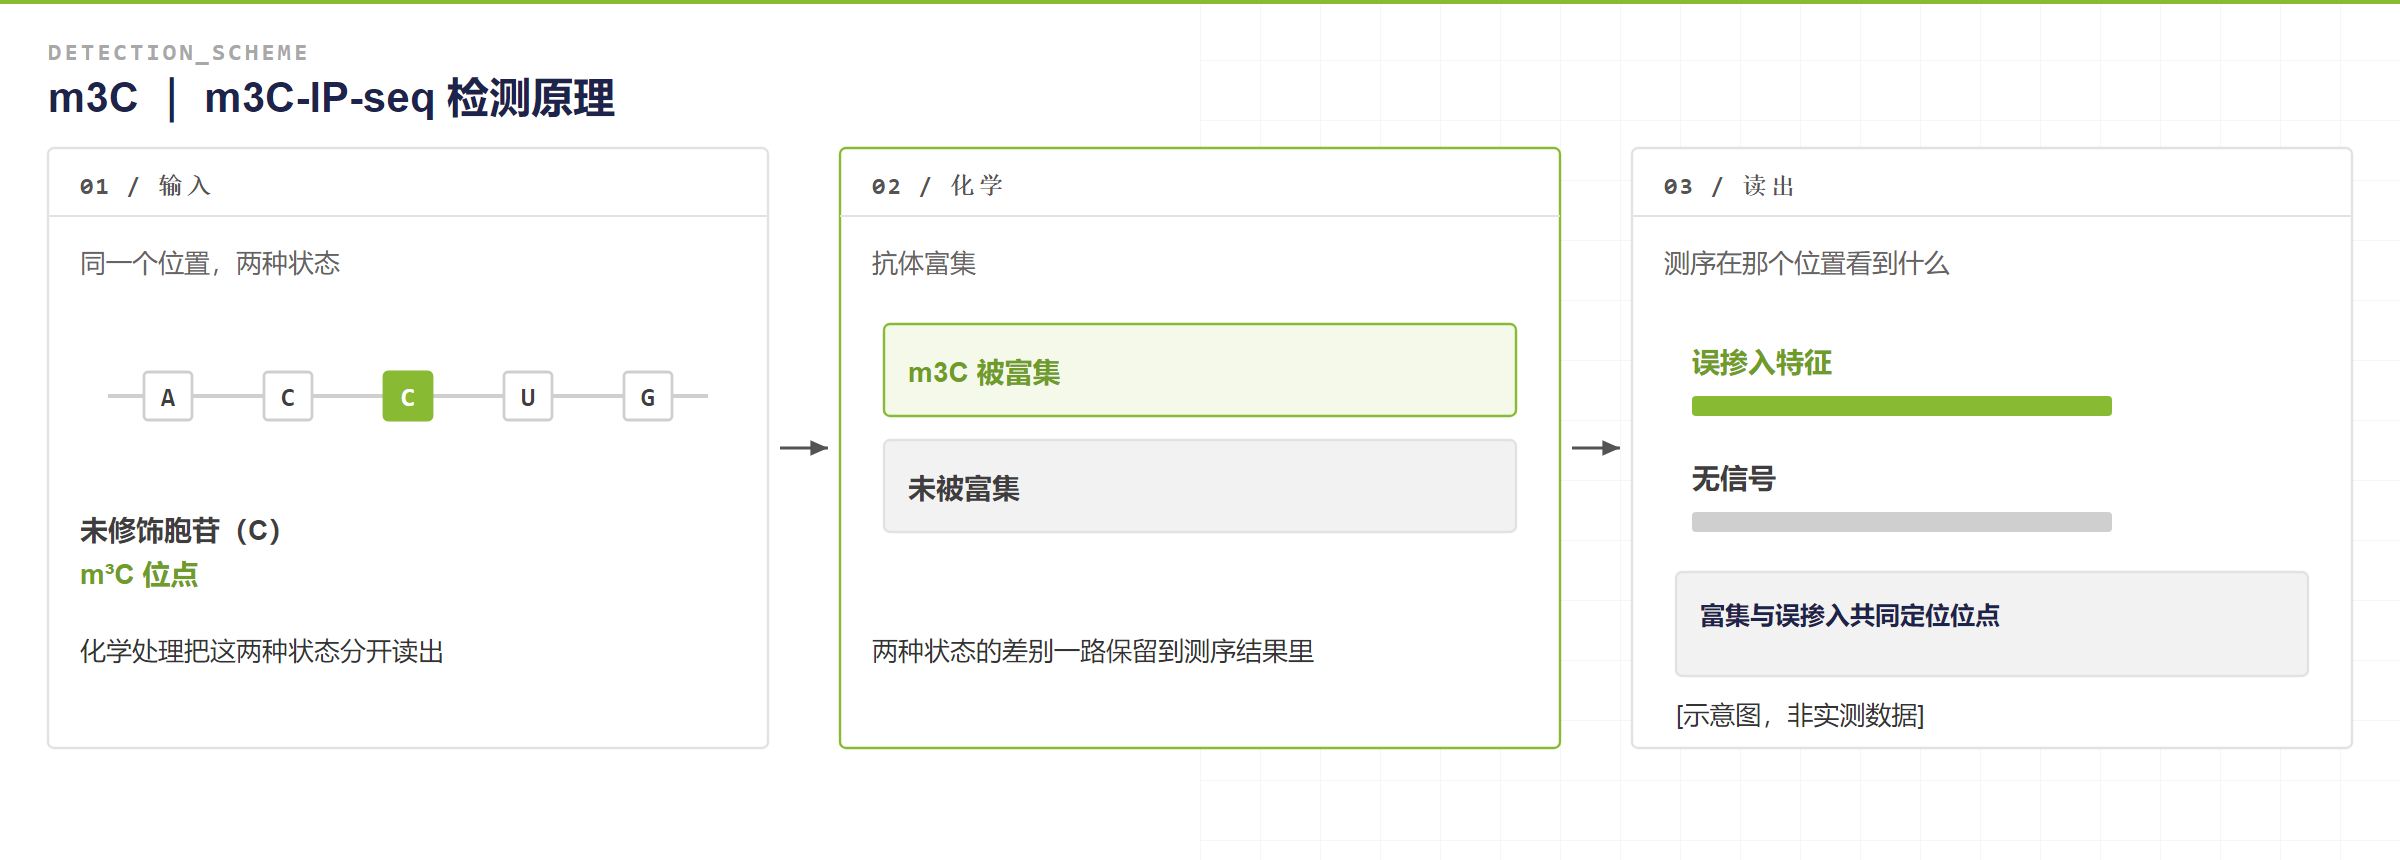
m3C 在转录本上的丰度总体偏低。如果把 total RNA 直接建库测序,弱修饰位点很容易淹没在背景里,判读不到。
m3C-IP-seq 用两步化解这个问题。第一步是免疫沉淀:抗体特异富集含 m3C 的片段,先提高目标片段在文库里的占比。第二步是逆转录错配读出(RT misincorporation):逆转录在修饰位点处留下特征信号,比对时读出这个信号,修饰核苷酸就落到单个碱基上。富集负责灵敏度,错配读出负责位点级判读,两者各司其职。长链非编码 RNA 同样纳入:mRNA 与 lncRNA 可以放在同一次实验中并行分析。
04实验流程
从样本到单碱基 m3C 数据共五步:
05生物信息分析与交付
比对完成后识别逆转录错配特征,锁定修饰位点并计算每个位点的 m3C 修饰水平。下游涵盖 motif 与 metagene 分布、组间差异、功能富集,以及可直接载入基因组的可视化轨道。
交付内容
- m3C mRNA 测序 FASTQ 原始文件,格式满足 GEO/SRA 等数据库的提交要求。
- 样本与测序两级质控报告,包含比对后的 BAM(已排序建索引)与核心比对统计。
- 单碱基 m3C 位点表(XLSX),逐位点给出基因组坐标、宿主基因与修饰水平。
- 转录本特征分布与 motif 一致性两张分析图(PDF/PNG)。
- 差异修饰分析表(XLSX),含组间倍数变化与显著性统计。
- 修饰基因的功能富集分析报告(HTML、PDF、PNG)。
- 可直接载入基因组浏览器的 bigWig/bedGraph 文件,以及完整项目报告。
06研究应用
- 富集定位:在 mRNA 与 lncRNA 上定位 m3C 位点,重点覆盖丰度偏低的修饰。
- 与化学路线互验:交叉确认肼-苯胺切割等无抗体路线提示的位点,两条独立证据分开核对。
- 翻译与稳定性:把位点水平的 m3C 与翻译效率、转录本半衰期的变化联系起来。
- 疾病导向:比较疾病与对照样本的修饰差异,缩小候选标志物的验证范围。
- 功能读数说明:翻译效率、转录本半衰期、蛋白或表型等功能读数由研究方或合作平台完成,不在本门户服务清单内。
07常见问题
为什么这条路线要先做免疫沉淀?
m3C 的丰度偏低,直接测序时弱位点的信号容易淹没在背景里。免疫沉淀先把含修饰的片段挑出来,目标片段占比提高之后,弱位点才有机会被读到。
富集之后再做错配读出,位点级信息会不会被拉回片段层面?
不会。富集针对的是含修饰的片段,逆转录错配读出针对的是片段里的修饰核苷酸;逆转录特征出现的位置仍然精确到单个碱基,富集只影响检出灵敏度,不改变判读的粒度。
低丰度样本为什么更适合这条路线?
因为信噪比在测序之前就被抬高了:目标片段先富集,测序数据里属于修饰位点的比例上升,同样深度下弱位点更容易过阈值。
和化学切割路线的结果对不上时怎么判断?
两条路线的偏倚来源不同 —— 富集路线受抗体效率影响,化学切割路线受切割效率影响。两条路线一致支持的位点可以优先进入后续验证;只在一条路线出现的位点,需要结合覆盖深度与重复实验再下判断。
这项服务是否也覆盖长链非编码 RNA?
覆盖。我们提供只做 mRNA、以及 mRNA 与 lncRNA 两种范围,两类转录本在同一次实验里一起分析。
08参考文献
- Gao Y, Hou J, Wei S, et al. Transcriptome-wide mapping of N3-methylcytidine modification at single-base resolution. Nucleic Acids Research 2025;53(5):gkaf153. DOI 10.1093/nar/gkaf153
- Cui J, Liu Q, Sendinc E, Shi Y, Gregory RI. Nucleotide resolution profiling of m3C RNA modification by HAC-seq. Nucleic Acids Research 2021;49(5):e27. DOI 10.1093/nar/gkaa1186