m6A RNA 修饰 RIP 测序(MeRIP-Seq)
抗体把带 m6A 的片段拉下来,再与未富集的输入对照比覆盖深度 —— 这条路线回答「哪些转录本、哪些区段上有修饰」,不回答具体在哪一个碱基。
01这项服务报告什么
它不改变碱基的读出结果,而是把带修饰的片段单独分出来,以片段丰度差异作为判读依据。交付的是富集区段表与富集图谱,不折算成位点级的修饰比例。
服务支持两种转录本范围:只做 mRNA,或把 mRNA 与长链非编码 RNA(lncRNA)并入同一次实验一起分析。
02服务优势
- 不做化学转化:路线不经过亚硫酸氢盐一类的剧烈处理,转录本承受的条件温和。
- 先分开再读:m6A 占比不高的样本,富集把目标片段的占比抬起来,信号更容易显现。
- 输入对照配套:同一份 RNA 留一份不富集,用来区分真正的富集与高丰度转录本造成的假象。
- 结论边界写清楚:交付内容明确结果停在区段层面,不把富集信号当成修饰含量来读。
- 与定位路线衔接:富集结果圈定候选区段,需要位点位置与修饰比例时交给单碱基路线。
可选转录本范围
mRNA|mRNA 与 lncRNA03背景与检测原理
m6A 是在腺嘌呤第六位氮上加一枚甲基,是 mRNA 上被研究得最多的一类内部修饰,与转录本稳定性、翻译效率和剪接联系在一起。它的化学改变不体现在配对行为上,常规逆转录测序读到的序列与未修饰的腺嘌呤完全一致。
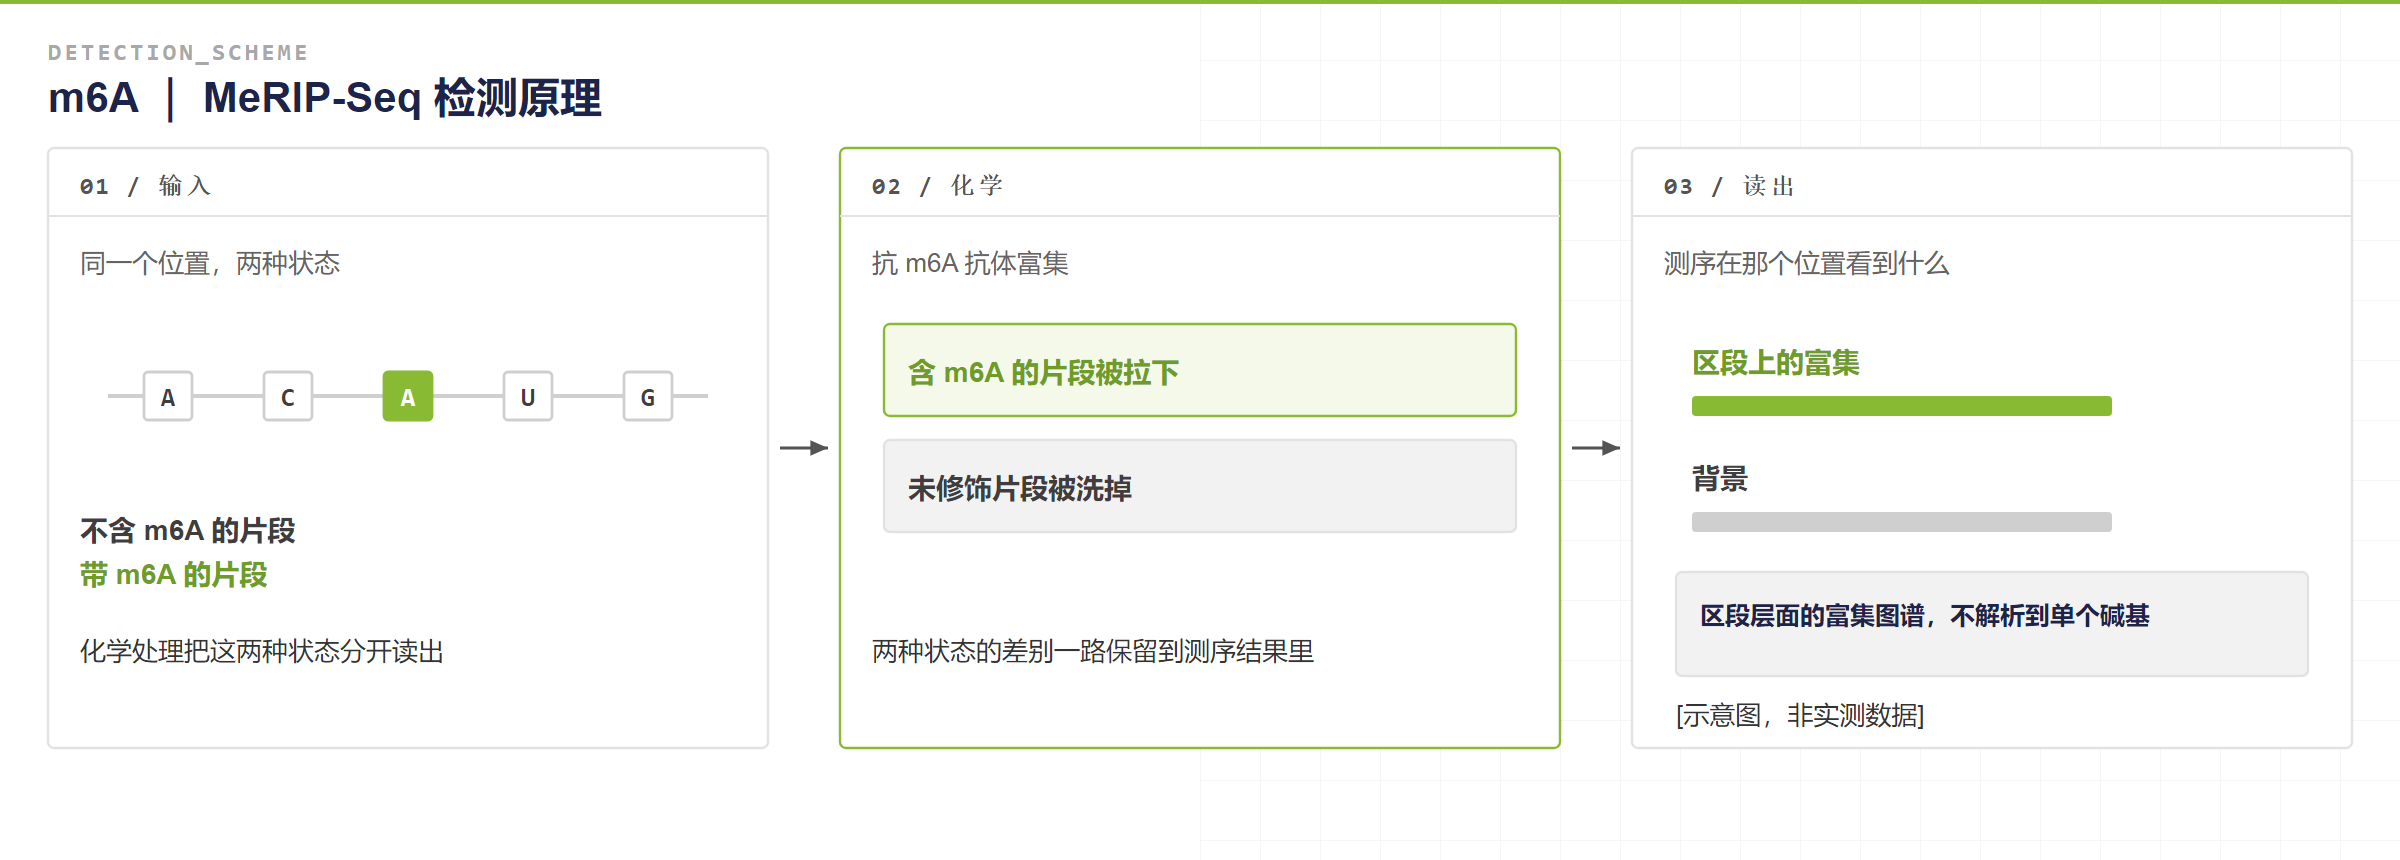
MeRIP-Seq 的做法是先分开再读:RNA 片段化后,含 m6A 的片段被抗体捕获,未修饰片段被洗掉,富集部分建库测序;同一份样本另取一份不富集,作为输入对照同时测序。比对后比较两组覆盖深度,被抬高的区段就显现出来。抗体对序列环境有偏好,抬高幅度受此影响,所以信号用来圈范围,而不是用来比较含量。
04实验流程
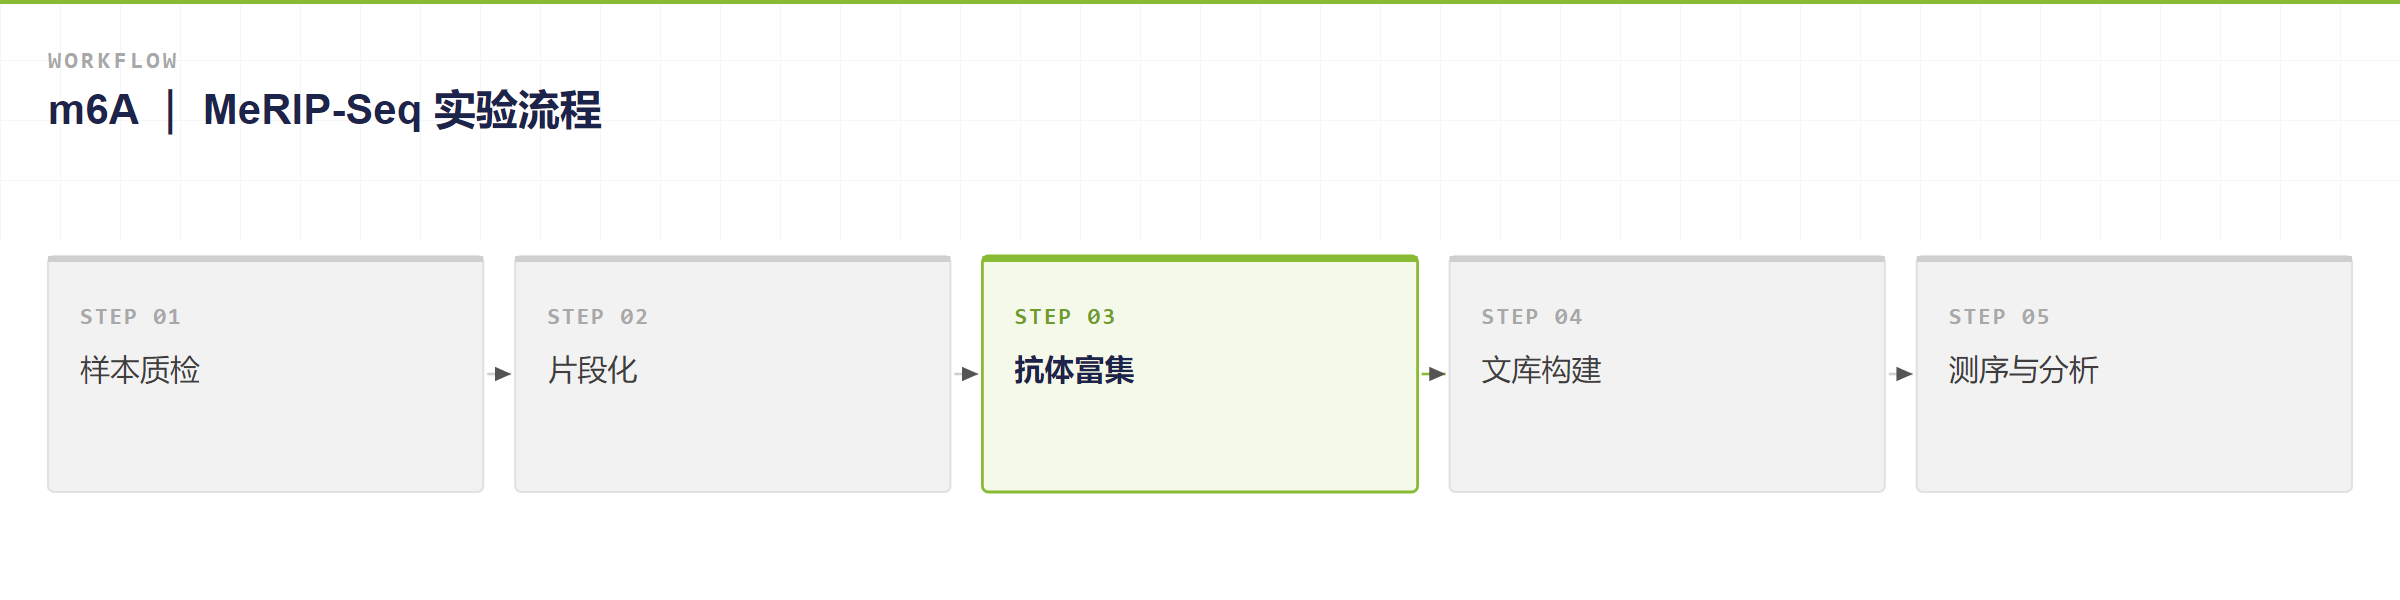
从 RNA 样本到区段富集图谱,见下图。
05生物信息分析与交付
分析把免疫沉淀与输入对照两组数据分别比对,比较覆盖深度后识别富集区段,再给出区段注释、分布特征与差异富集。比对与统计都以区段为单位,不输出位点级判读。
交付内容
- 免疫沉淀与输入对照两套文库的原始测序数据(FASTQ),可直接提交 GEO/SRA。
- 质控报告,含比对文件(BAM)与核心比对统计。
- 富集区段表(XLSX):区段坐标、宿主基因与富集倍数。
- 富集图谱与转录本分布图(PDF/PNG)。
- 差异富集分析表(XLSX),含倍数变化与统计显著性。
- 富集基因的功能富集报告(HTML/PDF/PNG)。
- 基因组浏览器轨道文件(bigWig/bedGraph)与结构化项目报告。
06研究应用
- 大样本初筛:先在多组样本上比较 m6A 的总体分布,筛出值得深入的对象再定路线。
- 转录本层面比较:看处理后或疾病状态下,哪些转录本的修饰分布发生变化。
- 候选区段圈定:为后续单碱基定位提供需要优先看的区段清单。
- 与表达数据对齐:把富集变化与同一批样本的表达变化放在一起看趋势。
07常见问题
MeRIP-Seq 能给出具体位点吗?
不能。抗体捕获的是片段,信号跨越的是区段;要位点位置与修饰比例需要另走单碱基路线。这条路线常作为第一步用来缩小范围。
富集倍数越高说明修饰越多吗?
不能这样读。富集倍数同时受抗体亲和力、片段长度和转录本丰度影响,它适合用来比较同一区段在不同样本之间的相对变化,不适合换算成修饰比例。
为什么每个样本都要做输入对照?
输入对照给出未富集时的背景。缺了它,高丰度转录本很容易看起来像「被富集」,差异也就无从判断。
样本量大的项目适合走这条路线吗?
适合。富集路线对测序深度的要求相对低,可以先把队列里的差异筛出来,再挑代表性样本做单碱基定位。
结果里的区段该怎么用于后续研究?
把富集区段与基因注释、表达变化对齐,先看趋势是否一致;需要落到具体位点时,再按这些区段设计单碱基实验。
08参考文献
- Dominissini D, Moshitch-Moshkovitz S, Schwartz S, et al. Topology of the human and mouse m6A RNA methylomes revealed by m6A-seq. Nature 2012;485(7397):201–206. DOI 10.1038/nature11112