m1A RNA单碱基测序(m1A-Quant-seq)
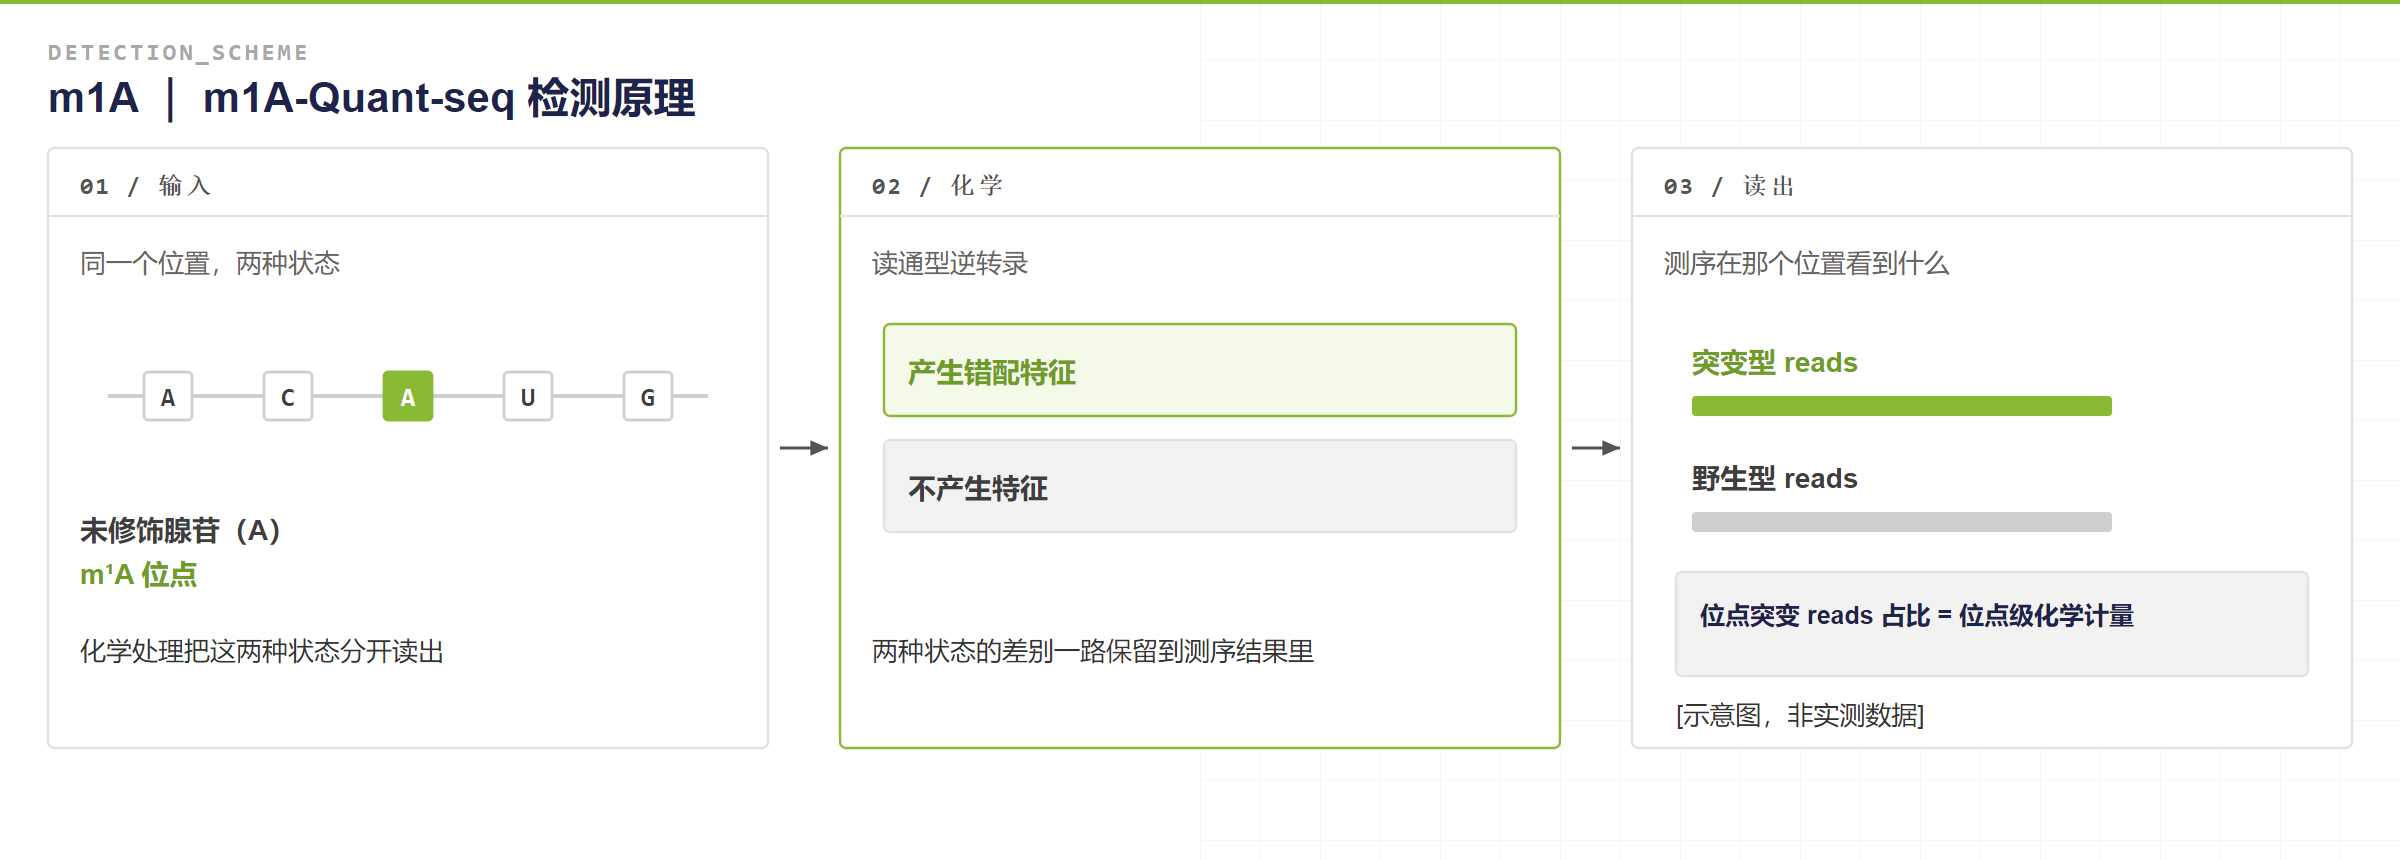
工程化逆转录酶在 m1A 位点不提前截断,而是读通过去并留下可重复的错配特征 —— 修饰位点定位到单个核苷酸,错配比例换算成该位点的修饰百分比。
01这项服务报告什么
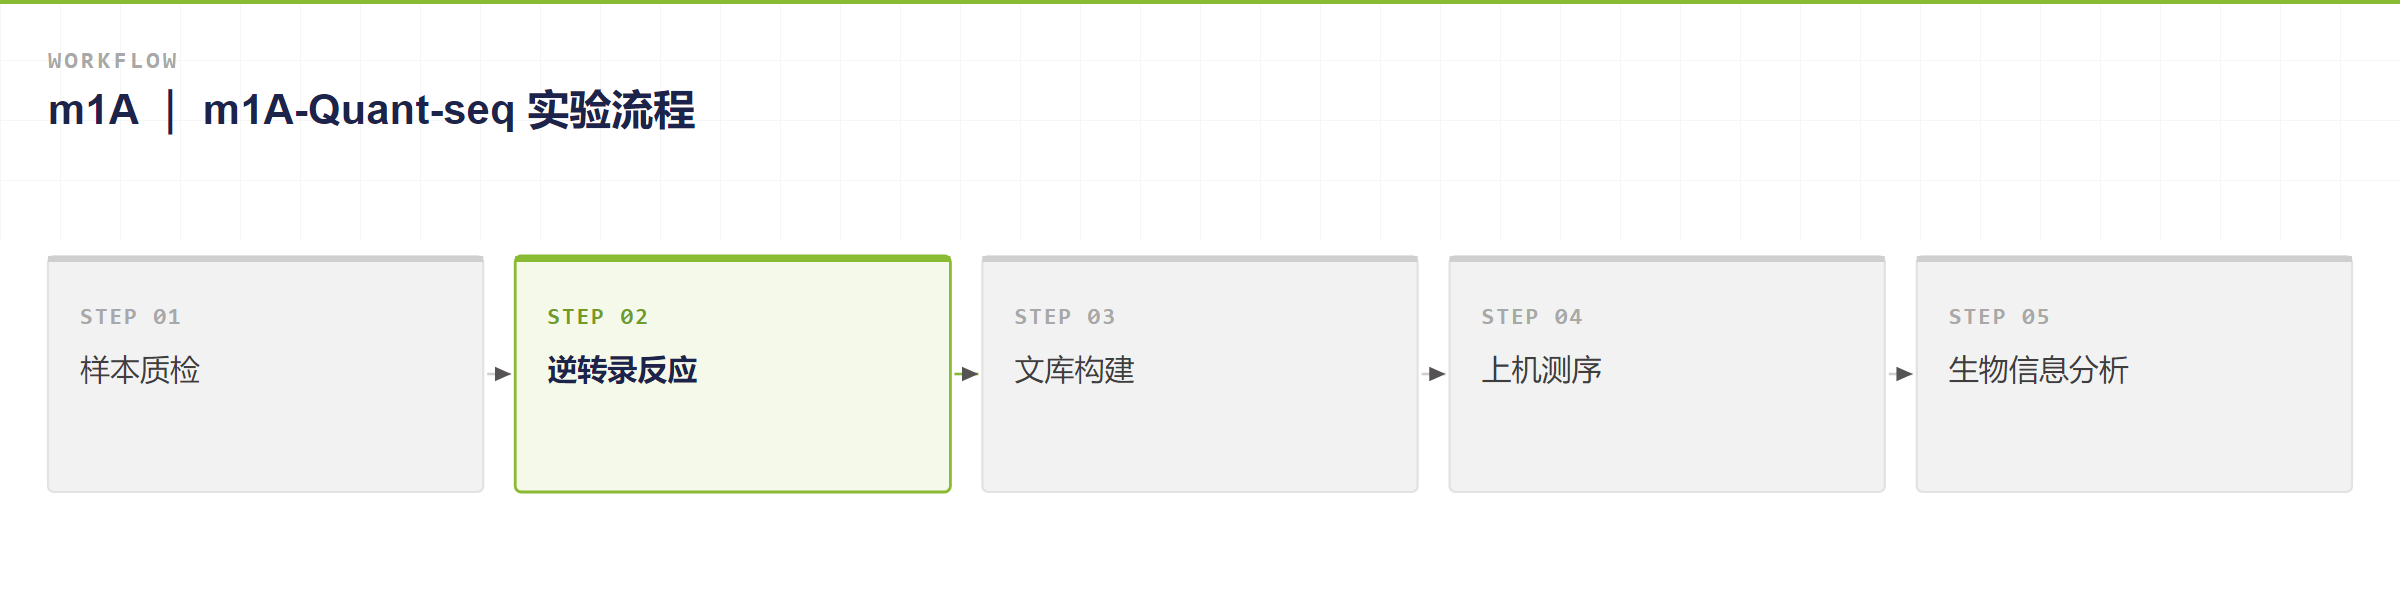
我们把这条路线整理成从样本到数据的完整流程:RNA 样本质检、文库构建、高通量测序、生物信息分析与注释,最后交付项目报告。研究者拿到的是可以直接使用的 m1A 位点表与图谱,不必自己搭建这套实验体系。
服务提供三种可报告范围 —— mRNA、mRNA 与 lncRNA、以及 rRNA。rRNA 位点按参考 rRNA 坐标单独注释,可判读范围取决于 m1A 在 rRNA 上的丰度与测序覆盖。
02服务优势
- 读通型逆转录:工程化逆转录酶读通 m1A 而不提前截断,cDNA 覆盖修饰位点,位点因此能被完整判读。
- 突变率即化学计量:每个位点上可重复的错配比例直接换算成 m1A 修饰百分比,给出的是位点级定量(可跨样本比较的修饰比例)。
- 分辨率跨越富集路线:抗体法停留在峰宽量级,这条路线把判定落到单个核苷酸位置。
- 无抗体步骤:不使用 m1A 抗体,不依赖抗体结合偏好,回避免疫沉淀的交叉反应与批间差异。
- 注释到功能位点:每个位点给出基因组坐标、宿主基因,以及密码子位置、对应氨基酸与进化保守性等注释。
可选转录本范围
mRNA|mRNA 与 lncRNA|rRNA03背景与检测原理
抗体富集路线把 m1A 的判读留在片段上:分辨率受峰宽限制,又常伴随逆转录在修饰位点处的停滞,位点级定量难以稳定拿到。
m1A-Quant-seq 从逆转录这一步切入。工程化逆转录酶在 m1A 处正常读通,并在该位点留下可重复的错配特征;比对时读出这个特征,就能把修饰位点定位到单个核苷酸,再把错配比例换算成该位点的修饰百分比。定位与定量来自同一份信号,不再依赖富集强度。
04实验流程
从样本到单碱基 m1A 数据共五步:
05生物信息分析与交付
reads 比对到参考转录本后,在单核苷酸分辨率上定位 m1A 并换算修饰百分比;分析覆盖 motif 特征、metagene 分布、差异修饰与功能富集,并给出基因组浏览器可视化结果。
交付内容
- 原始 m1A mRNA 测序数据文件(FASTQ),格式可直接提交 GEO/SRA 等公共数据库。
- 样本质控与测序质控报告,含排序并建索引的 BAM 比对文件与核心比对统计。
- 高置信度单碱基 m1A 位点表(XLSX),含基因组坐标、宿主基因、修饰百分比、密码子位置、对应氨基酸与进化保守性注释。
- 转录本特征分布图与一致性 motif 分析图(PDF/PNG)。
- 单碱基分辨率差异 m1A 甲基化分析表(XLSX),含倍数变化与显著性统计。
- m1A 修饰基因的功能富集分析报告(HTML/PDF/PNG)。
- 兼容基因组浏览器的可视化文件(bigWig/bedGraph)与完整的项目分析报告。
06研究应用
- 位点级定量图谱:在 mRNA 与 lncRNA 上输出带修饰百分比的 m1A 图谱。
- 翻译调控:把位点级 m1A 水平与翻译效率、mRNA 稳定性放在一起解读。
- 转录本来源比较:比较核基因编码与线粒体编码转录本上 m1A 的分布差异。
- 疾病导向:在疾病与对照之间筛选差异修饰位点,收窄候选标志物的验证范围。
- 功能读数说明:翻译效率、转录本半衰期、蛋白或表型等功能读数由研究方或合作平台完成,不在本门户服务清单内。
07常见问题
为什么 m1A 用常规逆转录很难判读?
常规逆转录酶在 m1A 处容易停滞,cDNA 提前终止,位点信息反而被截断信号掩盖。读通型逆转录酶让 cDNA 越过修饰位点,位点才能被完整读出。
错配比例怎么换算成 m1A 百分比?
同一个位点上带错配特征的 reads 与总 reads 之比,就是该位点 m1A 的修饰百分比。这个比值在重复实验间稳定,给出的是位点级定量(可跨样本比较的修饰比例)。
和 m1A-MeRIP-seq 的分辨率差多少?
抗体路线的峰宽通常在 100–200 nt 量级,一个峰里往往叠着多个候选位点;m1A-Quant-seq 把判定落到单个核苷酸,对应位点可以直接读出百分比。
读通之后信号会不会变弱?
读通带来的是可重复的错配特征,而不是衰减的信号,修饰位点仍由同一批 reads 支撑;判定时会把该特征与测序本身的错误分开,避免把噪声算成修饰。
哪些研究问题适合用这条路线?
适合需要位点级、可跨样本比较的 m1A 定量,例如修饰与翻译效率、转录本稳定性之间的关系,核基因与线粒体来源转录本的比较,以及疾病与对照之间的差异修饰筛选。
08参考文献
- Zhou H, Rauch S, Dai Q, et al. Evolution of a reverse transcriptase to map N1-methyladenosine in human messenger RNA. Nature Methods 2019;16(12):1281-1288. DOI 10.1038/s41592-019-0550-4
- Li X, Xiong X, Zhang M, Wang C, Qian SB, Yi C. Base-resolution mapping reveals distinct m1A methylome in nuclear- and mitochondrial-encoded transcripts. Molecular Cell 2017;68(5):993-1005. DOI 10.1016/j.molcel.2017.10.019